← All projects In preparation
A harmonised global dataset of preprints, 1990–2025
One clean record for every preprint, harmonised across Crossref, DataCite and OpenAlex.
Problem
Preprint metadata are split across Crossref, DataCite and OpenAlex, with inconsistent server names and duplicate records.
Approach
Built harvesters for each source, wrote rules to identify preprint servers, linked versions and removed duplicates.
Result
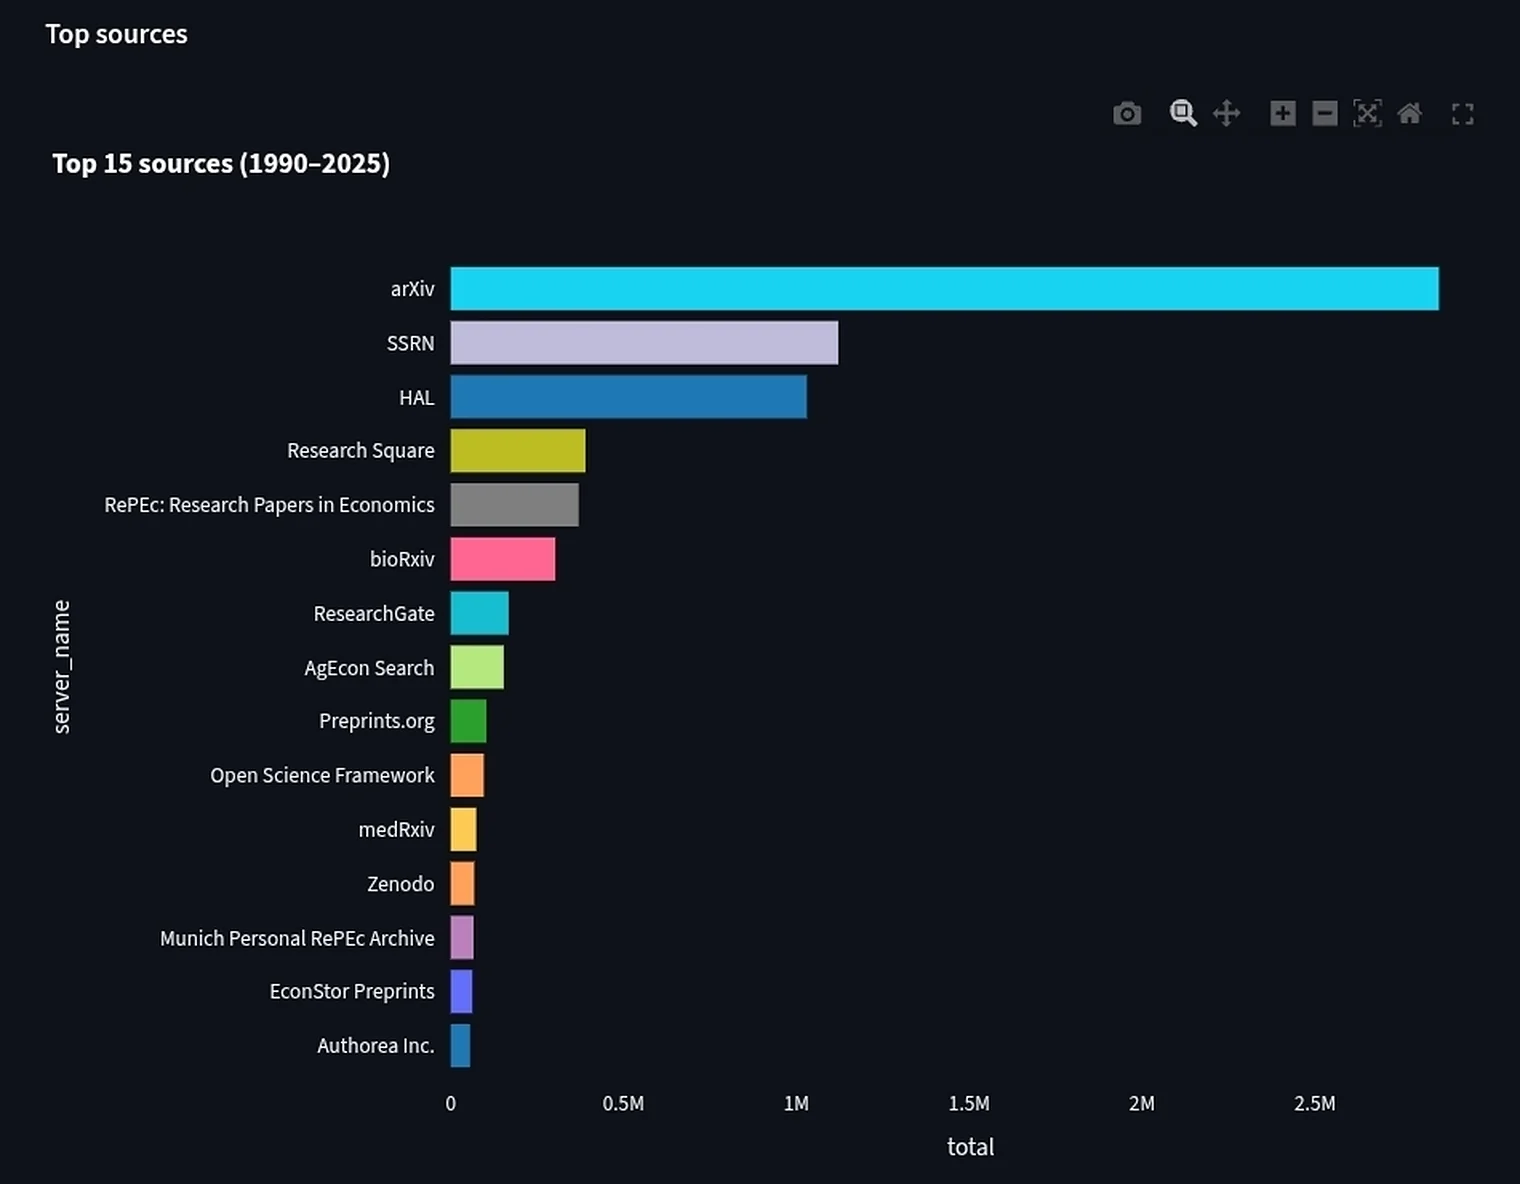
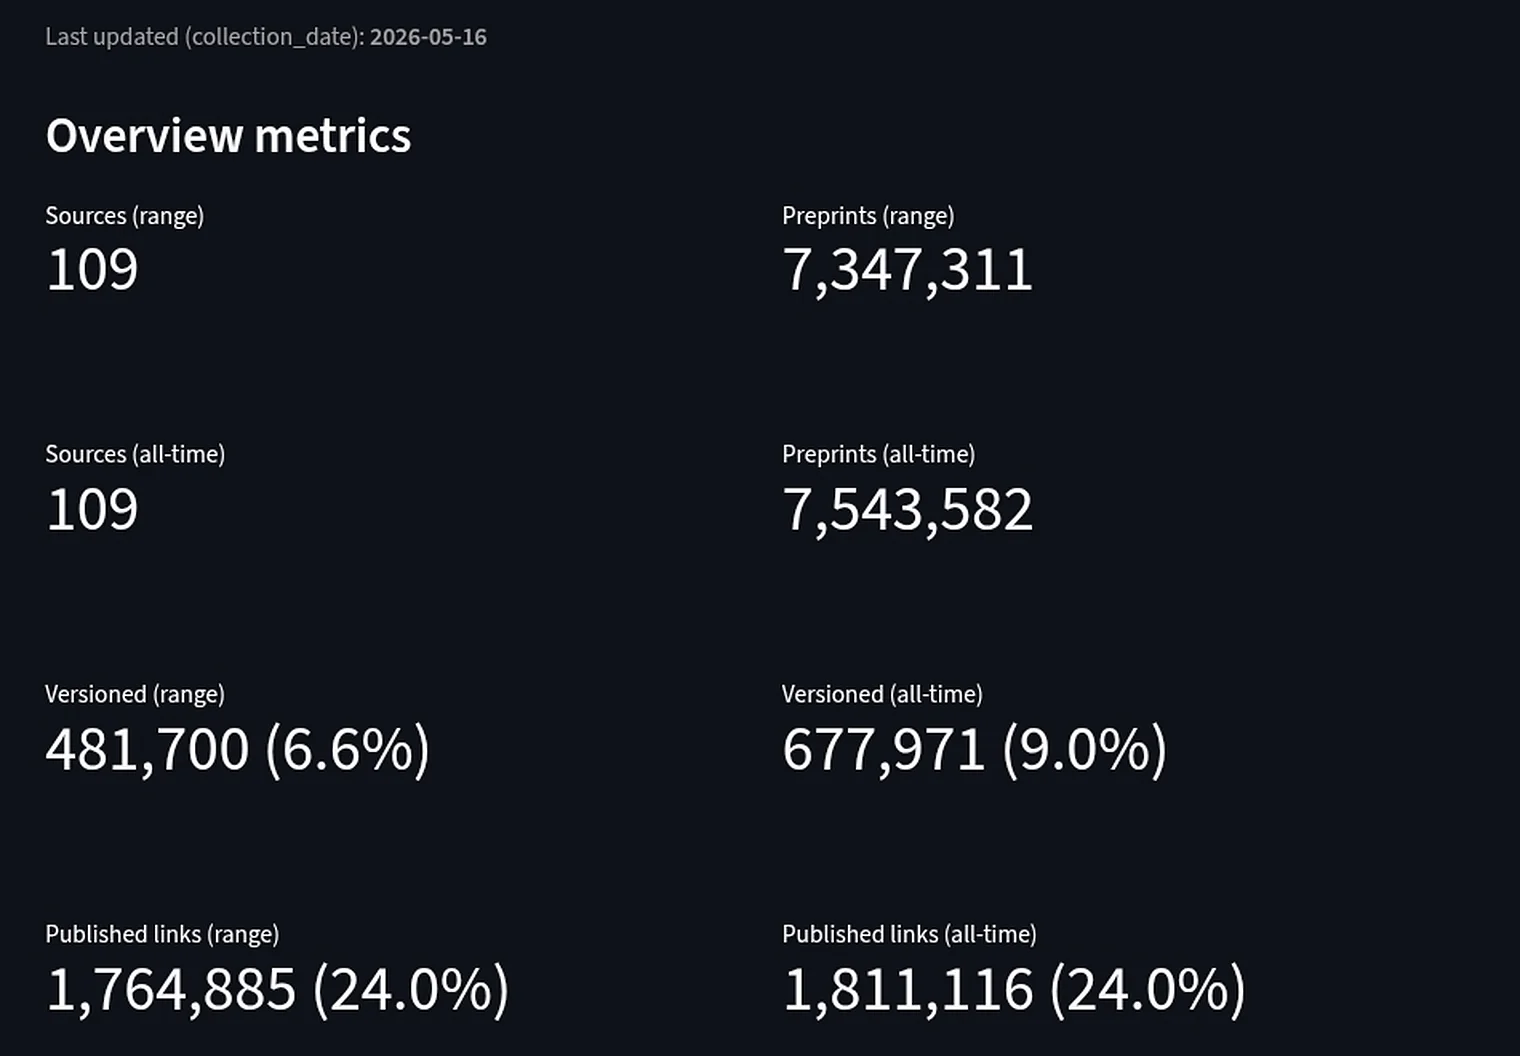
7,905,699 harvested records reduced to 7,332,492 parent records from 109 servers; dataset paper in preparation for Quantitative Science Studies.
My role
Lead author and data engineer at ScholCommLab, Simon Fraser University.
Outputs
Harmonised dataset; harvesters; manuscript in preparation